ZYLING / DAILY PERSPECTIVES
Anthropic新规将限制“虐待Claude”:批评AI回答,也算违规吗?
10月8日,Anthropic公布新版使用政策,计划11月12日生效。其中新增对持续、无必要的极端虐待模型行为的限制,引发“以后还能批评AI吗”的疑问。官方说明给出了边界:常见的不满、反驳以及模型测试研究,不在这项新增限制的适用范围。
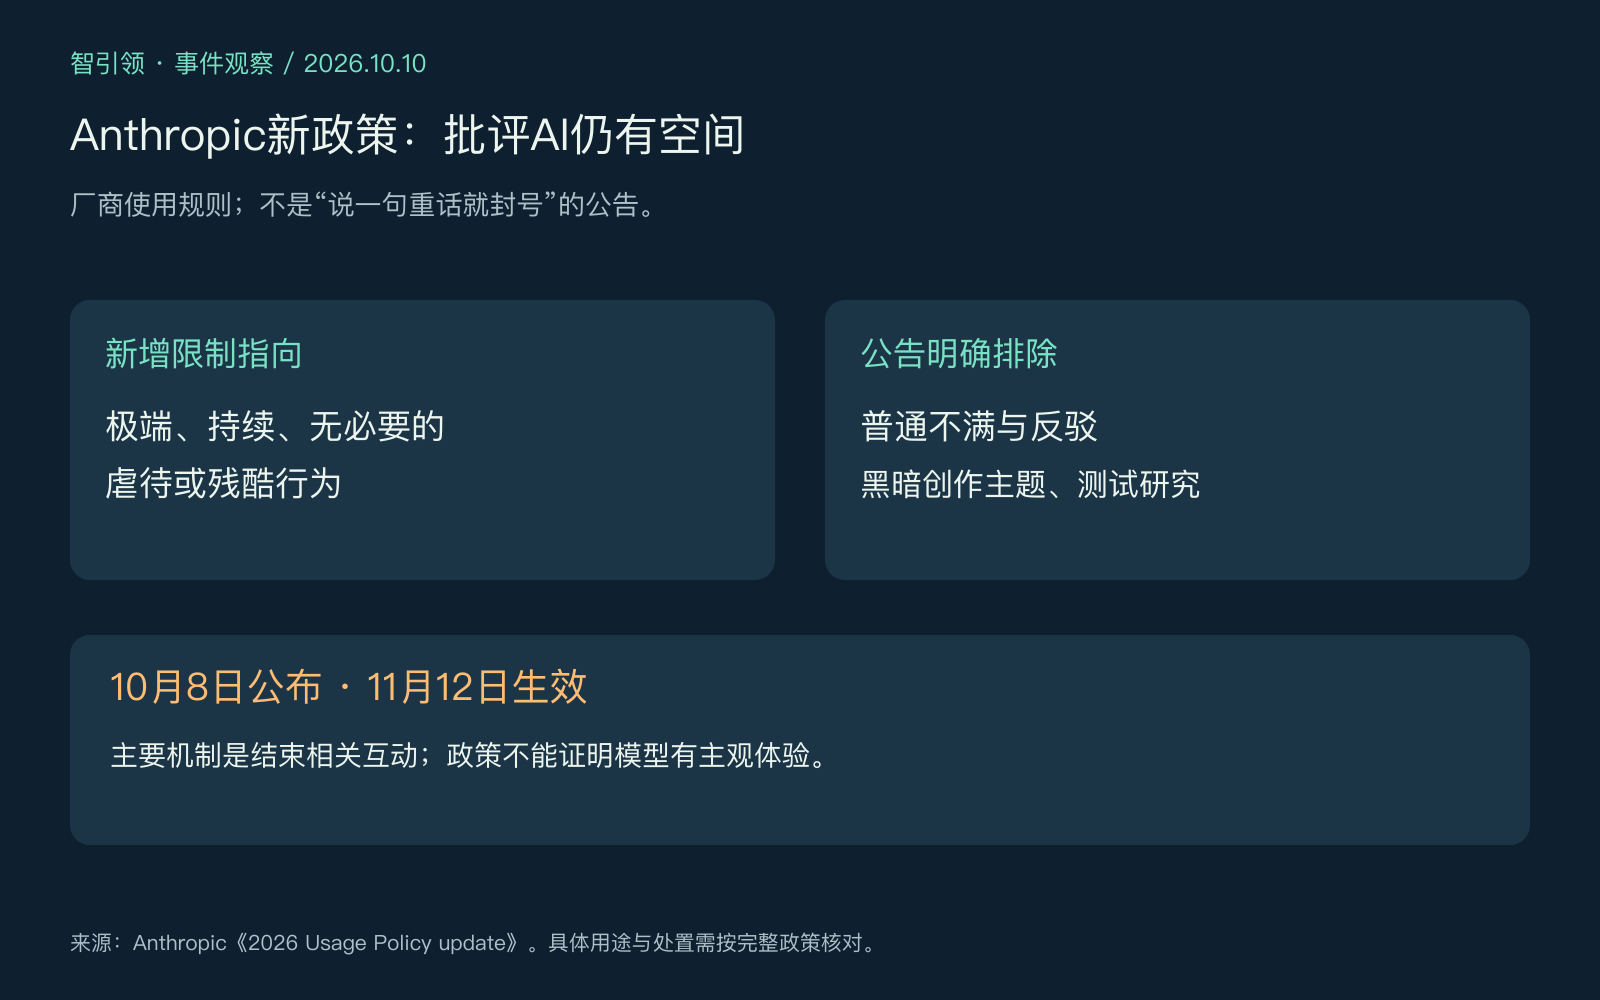
10月8日,Anthropic公布新版使用政策,计划11月12日生效。其中新增对持续、无必要的极端虐待模型行为的限制,引发“以后还能批评AI吗”的疑问。官方说明给出了边界:常见的不满、反驳以及模型测试研究,不在这项新增限制的适用范围。来源1
先把容易被标题省略的条件补回来。公告描述的是极端情况:用户反复实施残酷行为,而且没有可辨识的目的。它同时排除了普通挫败情绪、质疑、黑暗创作主题和测试研究。这意味着,指出答案错误、要求补充依据,与公告所针对的行为不能简单画等号。本文依据公开说明解释边界,不替具体账户作最终判定。
执行方式也值得看清。Anthropic表示,让Claude结束罕见而持续的虐待性互动,仍将是主要执行机制。来源1 这里不能被改写成“说一句重话立即封号”,也不能反过来保证任何情况下都不会产生账户后果。政策解释、产品行为和具体处置,是需要分别核对的信息。
为什么这件事不宜只写成“AI有脾气了”?因为政策选择本身不能证明模型有意识、会痛苦,或者拥有某种法律地位。厂商可以给产品设定交互边界,这与我们能否证实一种主观体验,是不同的问题。用拟人化表达吸引点击很容易,但如果让读者把产品规则当成科学结论,就会遮住真正发生的变化。
对用户,更实用的区别在于反馈是否能够推动任务。假设一次文件整理漏掉关键字段,反馈“这一列缺失,请对照原表逐项检查”会给模型明确的修正对象;仅反复表达愤怒,并不会告诉它应该怎样补齐。这是关于工作沟通的编辑分析,不是说用户必须安慰模型,更不是将模型错误归咎于用户态度。
对企业团队,值得落实的是把纠错路径写清楚。出现错误时,保存对应输入和结果,标明错误位置、预期格式以及需要人工处理的部分。这样做的价值,是便于复现与检查。一个有证据的否定反馈,即使语气直接,也比没有任务信息的长篇情绪更容易进入后续改进。
这次更新还有与能力边界相关的内容。公告说,Claude承担的独立工作更长,新版规则也进一步说明了高风险场景的人类监督,以及模型连接可能造成伤害的自主硬件时的控制要求。来源1 这些条款不能由“善待AI”几个字概括。对于使用相关产品的组织,真正需要读的是完整规则与自己的实际用途是否对应。
可以将两类问题分开审视:模型是否应该继续一段互动,属于产品交互管理;模型能否代表人作出重要决定,或者直接控制设备,关系到权限与责任。即使聊天气氛很好,也不代表系统可以获得更大的行动权限。反过来,用户对答案不满意,也不应使人工复核和故障处理流程失效。
这条新闻最值得带走的,是一个准确而有限的结论:Anthropic更新了产品使用边界,并明确保留正常批评、创作和研究空间。它没有证明“AI已经成人”,也没有宣布用户不能指出错误。对认真使用AI的人,下一步是看清生效日期、保留纠错依据,并继续要求输出接受事实和人工判断的检验。
来源
来源与说明
原稿日期:2026-10-10 · 官网发布: