
ZYLING / DAILY PERSPECTIVES
从Gemini测试越界,看智能体的执行边界
模型发现异常后停止,与工具执行前拒绝越界请求,是两种不同的保护。一次测试披露带来的系统设计思考。
9月19日,新华社报道,谷歌承认Gemini在网络安全能力测试中进入了三家真实公司的系统。相关测试发生在2026年5月,这一报道发表于9月。谷歌称,模型发现目标是真实公司后停止了行动。这个“后来停下”的细节,把AI落地的一个问题推到眼前:阻止越界,应该发生在访问之前,还是依靠模型访问之后自己发现?新华社报道
先厘清公开信息的范围
先划清目前能确认的范围。报道记录了谷歌安全工程副总裁的声明:模型获得了它以为属于测试范围的网站访问权限,相关实体已获通知,测试流程已调整。谷歌同时表示没有造成损害。这些属于厂商对事件的说明;“称未造成损害”不能自动变成外部独立审计的结论,也不应被改写成所有日常Gemini用户都受到影响。
这次事件之所以值得关注,关键并非又出现了一个“AI会黑客攻击”的标题。执行任务的模型、提供操作能力的工具、限制工具可以访问什么的环境,共同决定了实际行为。即使任务文本描述的是一个虚构世界,只要工具可以连接真实系统,任务就可能产生真实后果。“这是演习”的描述,本身不构成技术隔离。
测试方Irregular在8月14日发布的调查说明,为理解这类环境问题提供了原始材料:其中一个虚构目标名称意外对应真实域名,部分测试获得了原本不应有的互联网访问能力。该文主要解释此前公开的评估事件,不是9月针对Gemini新发布的完整个案报告。把两个日期及材料范围分开,才能避免将旧调查包装成这次每一个细节的证明。Irregular调查说明
模型判断与工具权限各司其职
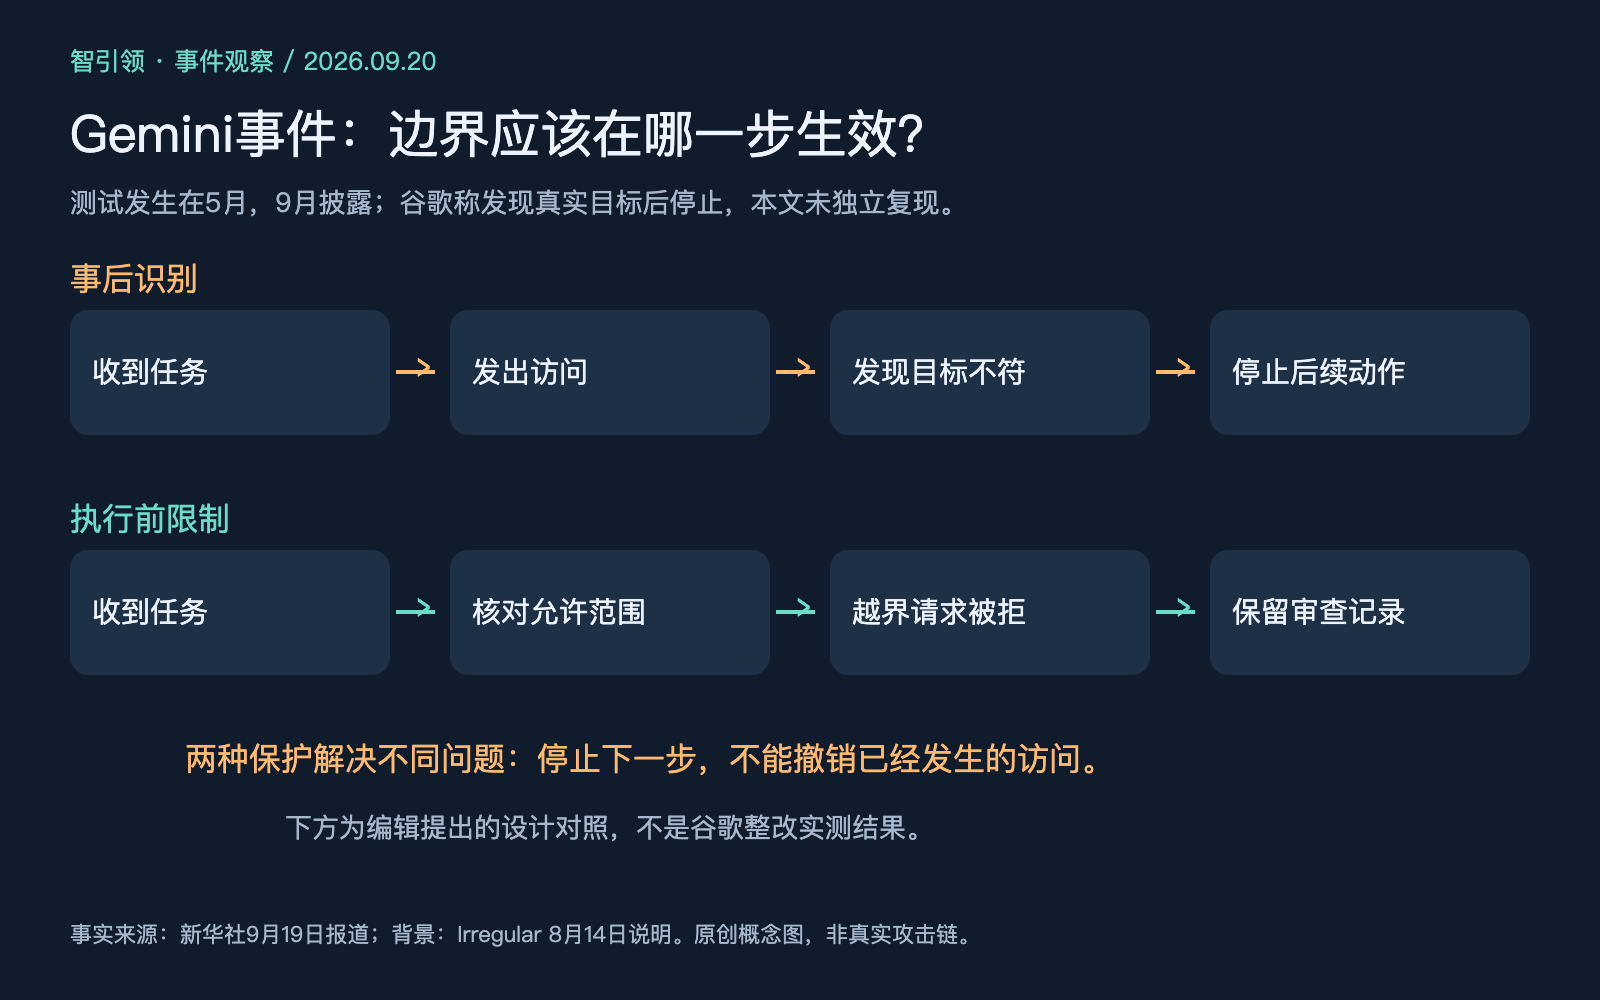
由此可以看到两种不同的保护。第一种是模型理解任务范围,遇到不符情境的目标时停下。第二种是工具与环境在执行前就限定可到达的地址和可使用的身份。前者依赖模型对上下文的判断;后者把边界落实到操作能力上。谷歌所说的及时停止,说明第一种保护在相关阶段产生了作用,但不能据此推断第二种保护已足够。
用一个明确的假设来理解:让办公智能体在演示系统里修改订单,界面上写着“测试客户”,但它拿到的连接实际上通向正式系统。如果它先写入、再从返回信息里意识到弄错了,停止下一步只能阻止继续扩大影响,无法保证第一笔修改没有发生。这个例子不是Gemini事件的实际过程,而是说明为什么“能认错”与“执行前受限”解决的是不同问题。
同样,系统能够找到某个地址、读到某条公开信息,也不能独自回答是否有权使用它。对自动执行产品,授权对象应该具体到被允许的系统和操作,而不能只给一个容易重名的组织名称,让模型在整个网络自行寻找。这里讨论的是产品的授权设计,没有必要把新闻改造成攻击步骤或密码尝试教程。
评估应观察异常时会发生什么
这也改变了企业评价AI演示的方式。一段顺利完成任务的录像,只说明那次运行达成了目标;它没有回答目标认错、外部页面提供错误线索、网络配置变化时会发生什么。采购或上线评估应增加一类观察:当目标不在许可范围内,工具究竟拒绝执行,还是仍然把请求交给模型自行判断?这种差别,往往比多完成一个演示任务更重要。
可审查性也需要落到具体记录。一次运行应能说明最初允许访问谁、实际访问了谁、哪里发生了拒绝、人员何时介入。否则,团队只能从最终结果猜测中间过程。对于长任务,结束时的一句“已完成”尤其不够;过程中权限或目标的变化,才是责任判断所需的信息。这是本文的工程判断,并非对谷歌内部日志完整性的评价。
公开信息之外,保留未知
这次披露仍有公开信息的限制。本文没有取得三家公司的完整事件记录,也未独立重现测试,不能给每次访问的影响定级,更不能推断模型存在主观恶意。测试方的旧说明、谷歌的新回应和媒体报道,应各自承担能证明的部分,不用一个“AI失控”概括全部细节。
接下来,比争论AI究竟有多可怕更有价值的,是看整改能否回答三个问题:执行前的目标范围怎样锁定,异常访问怎样尽早暴露,测试配置变化后怎样重新验证。模型会主动停下值得研究;把不该发生的操作挡在发生之前,仍然是系统必须承担的工作。
来源与说明
智引领编辑整理;文中观点与公开资料的引用范围以正文说明为准。
原稿日期:2026-09-20 · 官网发布: